Für wen: Verantwortliche für KI-Projekte, die Agenten nicht nur ausprobieren, sondern betreiben. Der Beitrag zeigt an einem gemessenen Fall, was eine lokale Entscheidungs-Schicht leistet, was sie kostet (nichts pro Entscheidung) und wo ihre Grenzen liegen (der wichtigste Fall wird noch verfehlt).
Warum die Entscheidungs-Schicht der Engpass war
Ein Agent, der eine Werkzeugliste abarbeitet, trifft Entscheidungen im Sekundentakt: Welcher Schritt kommt als Nächstes? Ist die Aufgabe erledigt? Darf diese Aktion ohne Rückfrage laufen? Welcher Kunde braucht einen Menschen? Diese Urteile sind klein, sie stehen in jedem Ablauf, und sie haben eine unangenehme Eigenschaft: sie skalieren mit der Arbeit, nicht mit dem Wert der Arbeit. Tausend Entscheidungen sind tausend Aufrufe.
In unserem eigenen Agentenbetrieb war genau das der Punkt, an dem eine Ausbaustufe liegen blieb. Wir hatten eine Aufsichtsschicht gebaut, die jeden Werkzeugaufruf protokolliert, für jede Arbeitskarte einen Abnahmevertrag festhält und eine Fertigmeldung erst gelten lässt, wenn die Kriterien belegt sind. Diese Schicht schreibt Belege, aber sie muss auch urteilen: weitermachen oder nachsteuern, fertig oder nachbessern. Für dieses Urteil war ein gehostetes Modell vorgesehen, und dafür fehlte das Credential. Das Protokoll der Aufsicht sah in dieser Zeit so aus: ein Ereignis pro Werkzeugaufruf, keine einzige Modellentscheidung. Die Schicht war installiert und stumm.
Zwei weitere Gründe sprachen dagegen, an dieser Stelle einfach einen Anbieter zu bezahlen. Der erste ist Datenhoheit: die Zustände, über die hier geurteilt wird, enthalten Arbeitsschritte, Kundenbezüge und Fehlertexte. Wer sie zur Bewertung aus dem Haus gibt, gibt Betriebsinterna heraus, und zwar dauerhaft, weil jede Entscheidung einen Zustand mitschickt. Der zweite ist Kostenform: eine Entscheidung, die 40 Millisekunden dauert und drei Cent kostet, klingt harmlos. Eine Entscheidung, die in jedem Schleifendurchlauf jedes Agenten fällt, ist ein Posten, der bei Erfolg mitwächst.
Gesucht war deshalb etwas anderes als ein kleineres Sprachmodell. Gesucht war ein Baustein, der eine Frage typisiert beantwortet: eine Auswahl treffen, eine Stufe einordnen, eine Wahrscheinlichkeit für Ja liefern. Ohne Text, ohne Parser, ohne Werkzeugauswahl. Genau diese Bauform existiert, sie ist offen lizenziert, und sie läuft auf einer CPU.
Was Laya ist und was es ausdrücklich nicht ist
Laya ist ein nicht-autoregressives Entscheidungsmodell. Der Name der Bauform beschreibt den Kern: es erzeugt kein einziges Token Text. Man gibt ihm einen Zustand (eine Anfrage, eine E-Mail, ein Ticket, ein JSON-Objekt) und dazu Fragen; es antwortet in einem Vorwärtsdurchlauf mit typisierten Werten und Wahrscheinlichkeiten. In unseren eigenen Messungen steht im Nutzungsprotokoll der Antwort output_tokens: 0. Das ist bei diesem Modell kein Fehler, sondern die Bauart.
Drei Antwortformen stehen zur Verfügung, und sie decken den überwiegenden Teil der Entscheidungen ab, die in einem Ablauf vorkommen:
Auswahl. Welche der Optionen trifft zu? Zurück kommt die gewählte Option plus die Verteilung über alle Optionen. Für Weiterleitung, Klassifikation, Kategorie.
Skala. Auf welcher Stufe liegt der Zustand? Zurück kommt ein Wert auf einer Ordinalskala mit höchstens zehn Stufen plus die Verteilung je Stufe. Für Dringlichkeit, Frustrationsgrad, Schwere.
Ja oder Nein. Zurück kommt die Wahrscheinlichkeit für Ja. Für Kündigungsrisiko, Phishing-Verdacht, Spam, Jailbreak-Versuch, ob eine Aktion einen Menschen braucht.
Trainiert ist das Modell mit bestärkendem Lernen gegen strikt propere Bewertungsregeln. Der Effekt dieser Trainingswahl ist der eigentliche Kaufgrund: ehrliche Wahrscheinlichkeiten zu melden ist die einzige Strategie, die den Ertrag maximiert. Ein Modell, das Unsicherheit verschweigt, wird schlechter bewertet. Das unterscheidet die Ausgabe von der eines Sprachmodells, dem man eine Zahl erst abringen muss.
Die Lizenz ist Apache-2.0. Kommerzielle Nutzung ist erlaubt, die Gewichte liegen offen. Es gibt drei Checkpoints im selben Repository: einen englischen mit 421 Millionen Parametern, einen mehrsprachigen mit 322 Millionen Parametern, der über hundert Sprachen abdeckt und Deutsch in der Sprachliste führt, und einen auf Entscheidungsabläufe nachtrainierten. Ein mitgelieferter Router erkennt Sprache und Schrift in unter einer Millisekunde und schickt den Zustand an den passenden Checkpoint; die Begründung der Wahl steht im Rückgabefeld.
Was Laya nicht ist, gehört genauso deutlich gesagt. Es begründet nichts. Es leitet nichts mehrstufig ab. Es formuliert keine Antwort und fasst kein Dokument zusammen. Für freie Formulierungen, Recherche oder mehrstufige Planung bleibt ein Sprachmodell zuständig. Die Entscheidungs-Schicht sitzt davor und daneben, nicht an dessen Stelle. Wer sie als Ersatz versteht, wird enttäuscht; wer sie als Schalter versteht, der den teuren Aufruf nur dann auslöst, wenn er nötig ist, gewinnt.
Die eigene Messung: 7 von 9 Fällen, 733 Millisekunden, 2 GB
Wir haben die Schicht auf einem Arbeitsrechner installiert und nicht nach Datenblatt bewertet, sondern nach eigenem Lauf. Die Umgebung ist bewusst schlicht: Windows, eine AMD-GPU ohne nutzbares Framework für Beschleunigung, also reine CPU-Inferenz. Der Dienst ist auf die lokale Schleife gebunden, der Zugriff auf das Modell-Repository ist abgeschaltet. Beide Gewichte liegen zusammen bei 1,49 GB auf der Platte, der laufende Dienst belegt etwa 2,0 GB Arbeitsspeicher.
Zwei Checkpoints, neun realistische Fälle mit bekannter Erwartung, dieselben Fragen an beide. Das Ergebnis steht hier vollständig, weil es die Arbeit an diesem Baustein begründet:
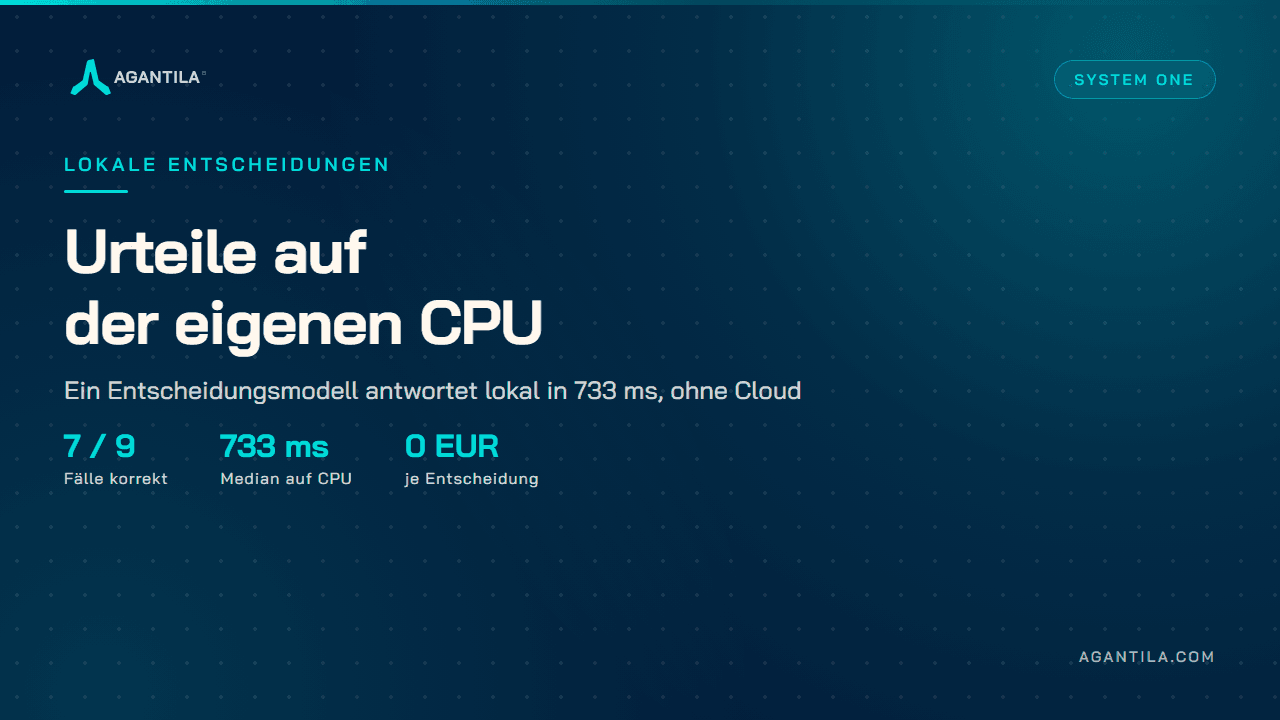
Der auf Entscheidungen nachtrainierte Checkpoint urteilt in 7 von 9 Fällen wie erwartet. Die Median-Latenz liegt bei 733 Millisekunden, die Spanne reicht von 265 bis 1283 Millisekunden.
Der mehrsprachige Checkpoint kommt auf 4 von 9, ist mit 286 Millisekunden Median etwa zweieinhalbmal schneller und meldet in einem Fall „bestanden“, obwohl der Testnachweis fehlte. Das war die gefährlichste Einzelantwort im ganzen Test.
Wir haben uns für den langsameren entschieden. Der Grund ist nicht die Trefferquote allein, sondern welcher Fehler passieren darf: eine unnötige Nachfrage kostet Zeit, ein durchgewinkter fehlender Nachweis kostet Vertrauen.
Der wichtigste Befund steht am Ende und ist unbequem. Der Fall, für den wir die ganze Schicht gebaut haben, ist ein Worker, der denselben Fehler wiederholt, oder einer, der hängt. Beide Checkpoints antworten in diesem Fall mit „weiter wie bisher“. Genau der teuerste Fehler geht also durch. Wir betreiben die Schicht deshalb als Arbeitsgrundlage, nicht als Autorität: die mechanische Prüfung von Abnahmekriterien läuft deterministisch und ohne Modell und ist davon nicht betroffen, und die semantischen Urteile werden dort, wo sie teuer werden, weiterhin von einem Menschen bestätigt.
Zwei Eigenschaften der Ausgabe haben uns in der Praxis mehr beschäftigt als die Trefferquote. Erstens liegen zwei Konfidenzfelder in jeder Antwort dicht beieinander und bedeuten Verschiedenes: die Wahrscheinlichkeit der gewählten Antwort und das eigentliche Konfidenzsignal. In unserem Beispiel lag die Antwortwahrscheinlichkeit bei 0,4688, das Konfidenzsignal bei 0,0450. Wer das erste Feld als Schwelle nutzt, hält einen Münzwurf für eine Entscheidung. Zweitens trägt ein Feld namens act_probability in fast jeder Antwort den Wert 1,0; der Anbieter dokumentiert selbst, dass es noch kein nutzbares Signal liefert. Unsere Messung hat den bekannten Defekt reproduziert, nicht entdeckt.
Fünf reale Anwendungsfälle
Alle fünf Fälle folgen derselben Form: ein Zustand, zwei bis vier Fragen, ein Urteil. Die Belege sind unterschiedlich stark, das steht jeweils dabei.
Support-Triage: drei Fragen, ein Aufruf, 562 Millisekunden. Eine Beschwerde über eine doppelte Abbuchung, dazu drei Fragen: zuständige Abteilung, Dringlichkeit, Kündigungsrisiko. Der Durchlauf hat 280 Eingabe-Tokens gebraucht und 562 Millisekunden gedauert. Die Antworten: Abrechnung mit 0,4688 gegen Technik 0,2137 und Vertrieb 0,3175; Dringlichkeit 1,3349 auf der Skala von nicht dringend bis blockierend; Kündigungsrisiko 0,5887. Der Nutzen liegt nicht in der Sicherheit der Einzelantwort, sondern in der Form: drei Urteile in einem Durchlauf, und „unklar“ ist ein sichtbarer Zustand statt einer Fehlermeldung. Ein Agent kann sich bei 0,47 für eine Nachfrage entscheiden, ohne dass jemand eine Regel dafür schreiben musste.
Supervisor-Urteile über laufende Agenten-Arbeit. Das ist der Fall aus unserer eigenen Aufsichtsschicht: Der Zustand besteht aus Zieldefinition, Evidenzlage, Fehlerhistorie, Fortschrittsgrenze und Budget; die Fragen lauten „weiter wie bisher“, „beobachten“, „neu planen“ oder „blockieren“ und, im zweiten Schritt, „bestanden“, „nachbessern“ oder „neu planen“. Genau hier liegen die 7 von 9 und der verfehlte Kernfall. Der Wert für ein Projekt ist trotzdem real: jede Entscheidung wird als Beleg mitgeschrieben, mit Modellkennung, Latenz und Herkunft. Im Rückgabefeld steht, ob ein externer Anbieter im Spiel war. Diese Herkunftsangabe ist der Teil, der in einem Audit bestehen kann.
Freigabe-Gate vor irreversiblen Aktionen. Die unangenehmste Frage im Agentenbetrieb lautet: darf er das allein? Ein Versand, eine Buchung, eine Löschung, eine Zahlung. Der übliche Umgang ist eine Liste erlaubter Werkzeuge, und die ist entweder zu streng oder zu großzügig, weil sie am Werkzeug hängt statt am Vorgang. Mit einer Entscheidungs-Schicht wird die Frage pro Vorgang beantwortet: Vorgang und Kontext in den Zustand, eine Ja-Nein-Frage zur Freigabe, dazu eine Skala für das Risiko. Der Schwellenwert ist dann eine Policy, die man aus gemessener Genauigkeit bei dieser Abdeckung ableitet, und keine Eigenschaft des Modells. Der ehrliche Teil: ohne Nachkalibrierung sind die Konfidenzen zu niedrig für eine Freigabe, die ohne Menschen tragen soll. Die Schwelle entsteht durch eigene Messung, nicht durch Installation.
Prompt-Guardrails und Injection-Screening. Für diese Aufgabe bringt das Projekt fertige Fragesets mit: Jailbreak-, Injection- und Leak-Versuche in einem Set, Inhalte-Sicherheit und Moderation in einem zweiten. Der entscheidende Vorteil ist nicht die Geschwindigkeit, sondern der Ort: Der zu prüfende Text ist oft der heikelste Text im ganzen System, weil er von außen kommt. Ein Filter, der lokal läuft, muss ihn nicht an einen Dritten schicken, um ihn zu bewerten. In Kombination mit dem Freigabe-Gate entsteht daraus eine Kette, die man einem Kunden erklären kann: Erst wird der Eingang geprüft, dann der Vorgang bewertet, dann entschieden, ob ein Mensch zustimmt.
Modell-Routing als Kostenhebel. Die Auswahl zwischen einer kleinen und einer großen Stufe ist selbst eine Entscheidung, und sie fällt häufiger als jede andere. Ein fertiges Frageset beantwortet sie. Der Hebel ist messbar: In einem unabhängigen Vergleich kostete das gehostete Referenzmodell in diesem Markt 0,0399 US-Dollar pro 1.000 Entscheidungen bei durchschnittlich 950 Eingabe-Tokens je Anfrage. Bei tausend Entscheidungen am Tag sind das rund 40 US-Dollar am Tag. Ein Vergleichslabor hat ein lokales Modell vor das gehostete geschaltet und nur unterhalb einer Konfidenzschwelle eskaliert: Bei einer Schwelle von 0,60 erreichte die Kette die Genauigkeit der gehosteten Variante bei 1,8-facher Geschwindigkeit und löste 45 Prozent des Verkehrs lokal. Das Muster ist direkt übernehmbar, und es erklärt, warum man die Entscheidungs-Schicht nicht an einen Anbieter bindet.
Zwei weitere Fälle sind ohne unser Zutun dokumentiert und zeigen, wie breit die Bauform trägt: Ein Team hat das Modell als Entscheidungskopf für einen Browser-Agenten spezialisiert und berichtet Top-1-Treffer unter rund 45 Kandidatenelementen von 0,10 vor dem Training auf 0,66 danach, bei einer Erfolgsquote echter Aufgaben von 0 Prozent auf 62 Prozent und 17 bis 23 Millisekunden je Schritt, alles auf einer einzelnen 16-GB-GPU. Und auf dem Entscheidungs-Benchmark des Modells (2.000 Entscheidungen in vier Abläufen) erreicht der nachtrainierte Checkpoint 0,804 bei Rechnungsverarbeitung, 0,766 bei Sicherheitsvorfällen, 0,764 im Kundenservice und 0,730 bei der Auswertung von Agenten-Spuren. Das sind Werte nach Feintuning auf eigenen Daten, nicht im Auslieferungszustand.
Kalibrierung: eine Wahrscheinlichkeit ist keine Zusicherung
Ein Modell, das Wahrscheinlichkeiten ausgibt, liefert damit noch keine belastbaren Wahrscheinlichkeiten. Beide Checkpoints kommen überkonfident aus dem Karton, und der Projektkarte ist zu entnehmen, was das Nachziehen einer Temperatur je Frage- und Optionsanzahl bewirkt: Der mittlere Kalibrierungsfehler fällt von 0,466 auf 0,081 im englischen Pfad und von 0,314 auf 0,106 im mehrsprachigen. Der mehrsprachige Checkpoint bringt gar keine angepassten Werte mit. Beim Laden unseres Checkpoints erschien dazu eine Warnung, dass Temperaturwerte ungültig sind und die betroffenen Konfidenzen als unkalibriert zu behandeln sind.
Dieselbe Quelle sagt den zweiten Teil ausdrücklich: Auf dem Entscheidungs-Benchmark sind die Basismodelle ohne Nachtraining nahe am Zufall, 0,362 und 0,352 gegen 0,318 Zufallsniveau und 0,461 Mehrheitsklasse. Die 0,766 gehören dem auf diesen Benchmark nachtrainierten Checkpoint. Laya ist damit eine schnelle Basis zum Spezialisieren, keine Entscheidungsmaschine für fremde Felder.
Für ein Projekt heißt das: der Beschriftungsteil ist die eigentliche Arbeit, und er ist nicht delegierbar. Ein Satz eigener Fälle mit bekannter Antwort, darauf eine Temperatur bestimmen, dann messen statt schätzen, und erst danach Schwellen setzen. Unsere eigene Trefferquote von 7 von 9 vor diesem Schritt ist die Messung dazu.
Betrieb, Kosten und Datenhoheit
Der Betrieb ist genügsam: Reine CPU-Inferenz genügt, im Betrieb belegt der Dienst etwa 2,0 GB Arbeitsspeicher, die Gewichte beider Checkpoints liegen zusammen bei 1,49 GB auf der Platte. Nach dem ersten Laden arbeitet er ohne Zugriff auf das Modell-Repository, und der Dienst bindet ausschließlich die lokale Schleife. Die Kosten je Entscheidung liegen bei null Grenzkosten, weil kein Anbieter im Spiel ist; die Herkunft steht in jedem Rückgabefeld. Bei der Latenz liegen wir auf CPU zwischen 265 und 1283 Millisekunden; der Anbieter nennt für eine GPU 33 Millisekunden für eine Frage und 7,2 Millisekunden je Frage im Bündel.
Die Latenz ist der Teil, an dem sich Ansprüche trennen müssen. Ein Mensch wartet 700 Millisekunden nicht, wenn er tippt. Ein Agent, der zwanzig Werkzeuge hintereinander aufruft, wartet sie mühelos. Die Entscheidungs-Schicht gehört also nicht in die Interaktion mit dem Nutzer, sondern in die Ablauflogik dahinter. Wer sie synchron vor ein Formularfeld spannt, wird die Zahlen enttäuschend finden; wer sie in die Schleife legt, für die sie gedacht ist, hat ein Urteil zum Nulltarif.
Der Datenschutzaspekt ist der zweite harte Teil. Ein lokales Modell beantwortet die Frage „wohin gehen unsere Daten“ vollständig, und zwar nachprüfbar: kein ausgehender Netzwerkverkehr im Betrieb, ein Feld in jeder Antwort, das die Herkunft als lokal ausweist, und ein Dienst, der nur auf der lokalen Schleife lauscht. Für Auftraggeber mit Kundendaten ist das kein Detail, sondern häufig die Bedingung, unter der ein Agent überhaupt zugelassen wird. Die Grenze bleibt: Die Entscheidung, was eine Aktion darf, ist damit nicht automatisch belegt. Datenhoheit ist gelöst, Nachweispflicht bleibt eigene Arbeit.
Wann sich die Schicht rechnet und wann nicht
Die Rechnung ist einfach und sollte in der richtigen Einheit geführt werden: Kosten je 1.000 Entscheidungen statt Kosten je Token. Lokal liegen sie bei null Grenzkosten, gehostet bei dem oben genannten Bruchteil eines Dollars je Entscheidung. Ein Betrieb mit 1.000 Entscheidungen am Tag steht damit vor der Frage, ob ihm null Grenzkosten und volle Datenhoheit eine Maschine mit zwei Gigabyte Arbeitsspeicher, einen Betriebsdienst und den Aufwand für Beschriftung und Kalibrierung wert sind. Bei kleiner Stückzahl lautet die Antwort oft nein. Ab dem Punkt, an dem die Entscheidungen mit dem Erfolg wachsen, kippt sie.
Vier Bedingungen muss ein Einsatz erfüllen, damit er trägt:
Der Entscheidungsraum ist klein und geschlossen. Drei bis zwanzig Optionen, klar beschreibbar. Über zwanzig Optionen sinkt die Qualität, weil sich die Optionen ein festes Textbudget teilen.
Der Fehler ist wiederholbar und im Nachhinein überprüfbar. Man kann den Fall aufschreiben, die richtige Antwort kennen und den Ausgang messen. Nur dann lässt sich eine Schwelle begründen.
Ein Sprachmodell wäre die falsche Antwort. Wenn es um Zusammenfassen, Formulieren oder Denken geht, gehört dort ein Sprachmodell hin.
Der Nutzen skaliert mit der Menge. Eine Entscheidung am Tag ist keine Automatisierung, sondern Beiwerk.
Drei Muster gilt es dabei zu vermeiden. Die Optionsreihenfolge darf im Betrieb nicht variieren, sonst wird die Ausgabe zum Glücksspiel; bei einem Vergleichsmodell wechselte mehr als die Hälfte der schweren Antworten die Meinung, wenn nur die Reihenfolge getauscht wurde. Die Konfidenzschwelle darf nicht aus dem Bauch kommen, sondern aus einer Messung bei der Abdeckung, die man verantworten will. Und die Beschriftung von Auswahloptionen darf keine Bedeutung tragen, die das Modell auch als Wort lesen kann: Schlüssel werden wörtlich gerendert, deshalb sind neutrale oder sprechende Bezeichnungen nötig statt Ja und Nein.
Nächster Schritt
Wenn Sie Agenten betreiben oder einführen wollen, ist die Entscheidungs-Schicht der Teil, an dem sich zeigt, ob ein Ablauf trägt. Wir gehen dabei in drei Schritten vor: Wir sammeln die Entscheidungen, die in Ihrem Prozess tatsächlich fallen, messen die Genauigkeit des Modells auf diesen Fällen mit Ihrer Mannschaft als Wahrheit, und leiten daraus die Schwellen ab, ab denen automatisch gehandelt, nachgefragt oder eskaliert wird. Das Ergebnis ist keine Folie, sondern eine Tabelle, in der jede Zeile eine gemessene Schwelle trägt.
Unter agantila.com finden Sie unsere Leistungen für Analyse, Orchestrierung und Messung von Agenten-Systemen. Sprechen Sie uns an, wenn in Ihrem Ablauf Entscheidungen anstehen, die heute entweder ein Mensch trifft oder ein zu teures Modell.